这里记录一下整理的ChatGPT输出的关于强化学习的公式。2026-9-11更新。

强化学习公式

1. MDP 与回报

一个 一个无限/有限时域的马尔可夫决策过程(MDP)定义为:

M=(S,A,P,r,γ)\mathcal{M} = (\mathcal{S},\mathcal{A},P,r,\gamma)

轨迹概率为:

pθ(τ)=ρ(s0)∏t=0T−1πθ(at∣st) P(st+1∣st,at)p_\theta(\tau)=\rho(s_0) \prod_{t=0}^{T-1} \pi_\theta(a_t\mid s_t)\,P(s_{t+1}\mid s_t,a_t)

折扣回报:

Gt=∑k=0∞γkrt+kG_t = \sum_{k=0}^\infty \gamma^k r_{t+k}

优化目标:

J(θ)=Eτ∼pθ[G0]J(\theta)=\mathbb{E}_{\tau\sim p_\theta}[G_0]

2. 价值函数与优势

Vπ(s)=E[Gt∣st=s],Qπ(s,a)=E[Gt∣st=s,at=a]V^\pi(s)=\mathbb{E}[G_t|s_t=s],\quad Q^\pi(s,a)=\mathbb{E}[G_t|s_t=s,a_t=a]

优势函数:

Aπ(s,a)=Qπ(s,a)−Vπ(s)A^\pi(s,a)=Q^\pi(s,a) - V^\pi(s)

3. 原始策略梯度

对目标函数求梯度

∇θJ(θ)=∇θ∫pθ(τ) G0 dτ=∫∇θpθ(τ) G0 dτ.\nabla_\theta J(\theta) = \nabla_\theta \int p_\theta(\tau)\,G_0\, d\tau = \int \nabla_\theta p_\theta(\tau)\, G_0\, d\tau.

使用 Log-Derivative Trick:

∇θpθ(τ)=pθ(τ) ∇θlog⁡pθ(τ).\nabla_\theta p_\theta(\tau) = p_\theta(\tau)\,\nabla_\theta \log p_\theta(\tau).

∇θJ(θ)=∫pθ(τ) G0 ∇θlog⁡pθ(τ) dτ=Eτ∼pθ[G0 ∇θlog⁡pθ(τ)].\nabla_\theta J(\theta) = \int p_\theta(\tau)\, G_0\, \nabla_\theta \log p_\theta(\tau)\, d\tau = \mathbb{E}_{\tau\sim p_\theta} \big[ G_0\,\nabla_\theta \log p_\theta(\tau)\big].

因为环境转移 PP与参数 θ\theta无关:

log⁡pθ(τ)=∑t=0T−1log⁡πθ(at∣st)+常数.\log p_\theta(\tau) = \sum_{t=0}^{T-1}\log\pi_\theta(a_t\mid s_t) + \text{常数}.

对 θ\theta求导:

∇θlog⁡pθ(τ)=∑t=0T−1∇θlog⁡πθ(at∣st).\nabla_\theta \log p_\theta(\tau) = \sum_{t=0}^{T-1}\nabla_\theta \log \pi_\theta(a_t\mid s_t).

∇θJ(θ)=E[G0∑t=0T−1∇θlog⁡πθ(at∣st)].\nabla_\theta J(\theta) = \mathbb{E}\left[ G_0 \sum_{t=0}^{T-1}\nabla_\theta \log \pi_\theta(a_t\mid s_t) \right].

将 G0G_0展开到时间步级别,使用分段回报

Gt=∑k=0∞γkrt+k,G_t=\sum_{k=0}^\infty \gamma^k r_{t+k},

∇θJ(θ)=E[(∑k=0T−1γkrk)(∑t=0T−1∇θlog⁡πθ(at∣st))].\nabla_\theta J(\theta) = \mathbb{E}\left[ \left(\sum_{k=0}^{T-1} \gamma^k r_k\right) \left(\sum_{t=0}^{T-1} \nabla_\theta \log \pi_\theta(a_t\mid s_t)\right) \right].

∇θJ(θ)=E[∑t=0T−1∑k=0T−1γkrk ∇θlog⁡πθ(at∣st)].\nabla_\theta J(\theta) = \mathbb{E}\left[ \sum_{t=0}^{T-1}\sum_{k=0}^{T-1} \gamma^k r_k \,\nabla_\theta \log \pi_\theta(a_t\mid s_t) \right].

∇θJ(θ)=E[∑t=0T−1(∑k=0t−1γkrk+∑k=tT−1γkrk)∇θlog⁡πθ(at∣st)].\nabla_\theta J(\theta) = \mathbb{E}\left[ \sum_{t=0}^{T-1} \left( \sum_{k=0}^{t-1} \gamma^k r_k + \sum_{k=t}^{T-1} \gamma^k r_k \right) \nabla_\theta \log \pi_\theta(a_t\mid s_t) \right].

“过去的奖励”项的梯度为 0(因果性),故对每个固定的 tt,考虑第一项:

∑k=0t−1γkrk ∇θlog⁡πθ(at∣st).\sum_{k=0}^{t-1} \gamma^k r_k \,\nabla_\theta \log \pi_\theta(a_t\mid s_t).

在马尔可夫决策过程里,在时间 tt 选择的动作 ata_t 只会影响之后的状态和奖励(即 k≥tk \ge t部分),不会影响已经发生的过去奖励 r0,…,rt−1r_0,\dots,r_{t-1}。形式化一点,可以看作在条件于历史 ht=(s0,a0,…,st)h_t=(s_0,a_0,\dots,s_t)下, 过去的奖励 {rk}k<t\{r_k\}_{k < t}对 ata_t的分布是“常数”,于是:

E[∑k=0t−1γkrk ∇θlog⁡πθ(at∣st)]=E[(∑k=0t−1γkrk)E[∇θlog⁡πθ(at∣st)∣ht]].\mathbb{E}\big[\sum_{k=0}^{t-1} \gamma^k r_k \,\nabla_\theta \log \pi_\theta(a_t\mid s_t)\big] = \mathbb{E}\left[ \left(\sum_{k=0}^{t-1} \gamma^k r_k\right) \mathbb{E}\big[\nabla_\theta \log \pi_\theta(a_t\mid s_t)\mid h_t\big] \right].

但对任意分布 pθ(at∣st)p_\theta(a_t\mid s_t),有:

Eat∼πθ(⋅∣st)[∇θlog⁡πθ(at∣st)]=∇θ∑atπθ(at∣st)=∇θ1=0.\mathbb{E}_{a_t\sim \pi_\theta(\cdot\mid s_t)} [\nabla_\theta \log \pi_\theta(a_t\mid s_t)] = \nabla_\theta \sum_{a_t}\pi_\theta(a_t\mid s_t) = \nabla_\theta 1 = 0.

因此:

E[∑k=0t−1γkrk ∇θlog⁡πθ(at∣st)]=0.\mathbb{E}\big[\sum_{k=0}^{t-1} \gamma^k r_k \,\nabla_\theta \log \pi_\theta(a_t\mid s_t)\big] = 0.

“过去奖励 × 当前 log-prob 梯度”的期望为 0, 对梯度没有贡献,可以整体丢掉。保留“未来的奖励”项于是只剩下 k≥tk \ge t的那部分:

∇θJ(θ)=E[∑t=0T−1(∑k=tT−1γkrk)∇θlog⁡πθ(at∣st)],\nabla_\theta J(\theta) = \mathbb{E}\left[ \sum_{t=0}^{T-1} \left( \sum_{k=t}^{T-1} \gamma^k r_k \right) \nabla_\theta \log \pi_\theta(a_t\mid s_t) \right],

∑k=tT−1γkrk=γt∑k=tT−1γk−trk=γtGt,\sum_{k=t}^{T-1} \gamma^k r_k = \gamma^t \sum_{k=t}^{T-1} \gamma^{k-t} r_k = \gamma^t G_t,

Gt=∑l=0T−1−tγlrt+l.G_t = \sum_{l=0}^{T-1-t} \gamma^l r_{t+l}.

对某一个τ\tau,GtG_t是固定的。因此,我们得到:

∇θJ(θ)=E[∑t=0T−1γtGt ∇θlog⁡πθ(at∣st)].\boxed{ \nabla_\theta J(\theta) = \mathbb{E}\left[ \sum_{t=0}^{T-1} \gamma^t G_t\, \nabla_\theta \log \pi_\theta(a_t\mid s_t) \right]. }

4. 吸收γt\gamma^t到折扣状态分布 dγπ(s)d^\pi_\gamma(s)

我们想说明如果我们去采样不同的轨迹τ\tau,那么我们得到的各个状态的分布里面已经包含了γ\gamma,可以将其剔除上面的公式。

ff 表示一个定义在状态上的任意函数(arbitrary function),引入 f(s)f(s) 来说明任意关于状态的时间折扣求和,都可以改写成对折扣状态分布 dγπ(s)d^\pi_\gamma(s)的期望。

E[∑t=0∞γtf(st)]\mathbb{E}\Big[\sum_{t=0}^\infty \gamma^t f(s_t)\Big]

dγπ(s)=(1−γ)∑t=0∞γtP(st=s∣π).d^\pi_\gamma(s) = (1-\gamma) \sum_{t=0}^\infty \gamma^t P(s_t = s \mid \pi).

对策略π\pi,求期望。展开时间期望:

E[∑t=0∞γtf(st)]=∑t=0∞γt E[f(st)]=∑t=0∞γt∑sP(st=s∣π) f(s).\mathbb{E}\Big[\sum_{t=0}^\infty \gamma^t f(s_t)\Big] = \sum_{t=0}^\infty \gamma^t\, \mathbb{E}[f(s_t)] = \sum_{t=0}^\infty \gamma^t \sum_{s} P(s_t = s \mid \pi)\, f(s).

交换求和顺序:

=∑sf(s)∑t=0∞γtP(st=s∣π).= \sum_{s} f(s) \sum_{t=0}^\infty \gamma^t P(s_t = s \mid \pi).

定义于是

∑t=0∞γtP(st=s∣π)=11−γdγπ(s).\sum_{t=0}^\infty \gamma^t P(s_t = s \mid \pi) = \frac{1}{1-\gamma} d^\pi_\gamma(s).

代回原式

E[∑t=0∞γtf(st)]=∑sf(s) 11−γdγπ(s)=11−γ∑sdγπ(s)f(s).\mathbb{E}\Big[\sum_{t=0}^\infty \gamma^t f(s_t)\Big] = \sum_s f(s)\, \frac{1}{1-\gamma} d^\pi_\gamma(s) = \frac{1}{1-\gamma} \sum_s d^\pi_\gamma(s) f(s).

这可以写成对 dγπ(s)d^\pi_\gamma(s)的期望

E[∑t=0∞γtf(st)]=11−γ Es∼dγπ[f(s)]\mathbb{E}\Big[\sum_{t=0}^\infty \gamma^t f(s_t)\Big] = \frac{1}{1-\gamma}\, \mathbb{E}_{s\sim d^\pi_\gamma}[f(s)]

推广到 (st,at)(s_t,a_t)上同样地,对任意函数 g(s,a)g(s,a),有

Eτ[∑t=0∞γtg(st,at)]=11−γ Es∼dγπ,  a∼π(⋅∣s)[g(s,a)]\mathbb{E}_{\tau}\Big[\sum_{t=0}^\infty \gamma^t g(s_t,a_t)\Big] = \frac{1}{1-\gamma}\, \mathbb{E}_{s\sim d^\pi_\gamma,\; a\sim \pi(\cdot\mid s)}[g(s,a)]

令 g(st,at)=Aπ(st,at)∇θlog⁡πθ(at∣st)g(s_t,a_t) = A^\pi(s_t,a_t)\nabla_\theta \log \pi_\theta(a_t\mid s_t),则

E[∑tγtGπ(st,at)∇θlog⁡πθ(at∣st)]=11−γEs∼dγπ,  a∼π[Gπ(s,a)∇θlog⁡πθ(a∣s)]\mathbb{E}\Big[\sum_t \gamma^t G^\pi(s_t,a_t)\nabla_\theta\log\pi_\theta(a_t\mid s_t)\Big] = \frac{1}{1-\gamma} \mathbb{E}_{s\sim d^\pi_\gamma,\; a\sim \pi} \big[G^\pi(s,a)\nabla_\theta\log\pi_\theta(a\mid s)\big]

这里我们直接写成更常见的形式(省略显式 γt\gamma^t),其实这里求期望的对象已经变了

∇θJ∝E[∑tGt ∇θlog⁡πθ(at∣st)]\nabla_\theta J \propto \mathbb{E}\left[\sum_{t} G_t \,\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]

5. 引入基线,不改变策略梯度

我们要证明

E[b(st)∇θlog⁡π(at∣st)]=0\mathbb{E}\big[b(s_t)\nabla_\theta\log\pi(a_t\mid s_t)\big] = 0

首先展开条件期望

E[b(st)∇θlog⁡π(at∣st)]=Est[b(st)  Eat∼π(⋅∣st)[∇θlog⁡π(at∣st)]]\mathbb{E}\big[b(s_t)\nabla_\theta\log\pi(a_t\mid s_t)\big] = \mathbb{E}_{s_t}\left[ b(s_t)\; \mathbb{E}_{a_t\sim\pi(\cdot\mid s_t)} \big[\nabla_\theta \log\pi(a_t\mid s_t)\big] \right]

因为 baseline 不依赖动作,可以提出来。接着利用 log 概率的恒等式

Eat∼π[∇θlog⁡π(at∣st)]=∑atπ(at∣st)∇θlog⁡π(at∣st)\mathbb{E}_{a_t\sim\pi}\big[\nabla_\theta \log\pi(a_t\mid s_t)\big] = \sum_{a_t}\pi(a_t\mid s_t)\nabla_\theta \log\pi(a_t\mid s_t)

将 ∇log⁡π\nabla \log\pi写回去

=∑atπ(at∣st)∇θπ(at∣st)π(at∣st)=∑at∇θπ(at∣st)= \sum_{a_t}\pi(a_t\mid s_t) \frac{\nabla_\theta\pi(a_t\mid s_t)}{\pi(a_t\mid s_t)} = \sum_{a_t}\nabla_\theta \pi(a_t\mid s_t)

=∇θ∑atπ(at∣st)=∇θ1=0.= \nabla_\theta \sum_{a_t}\pi(a_t\mid s_t) = \nabla_\theta 1 = 0.

所以 baseline 项的期望为 0

E[b(st)∇θlog⁡π(at∣st)]=Est[b(st)⋅0]=0.\mathbb{E}[b(s_t)\nabla_\theta\log\pi(a_t\mid s_t)] = \mathbb{E}_{s_t}\big[b(s_t)\cdot 0\big] = 0.

6. GtG_t 替换成优势函数

Gt  →  Gt−b(st)G_t \;\to\; G_t - b(s_t)

利用基线不改变期望梯度

∇θJ=E[∑t(Gt−b(st)) ∇θlog⁡πθ(at∣st)]\nabla_\theta J = \mathbb{E}\left[\sum_t (G_t - b(s_t)) \,\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]

取

b(st)=Vπ(st),Aπ(st,at)=Gt−Vπ(st)b(s_t) = V^\pi(s_t), \quad A^\pi(s_t,a_t) = G_t - V^\pi(s_t)

得到策略梯度的优势形式

∇θJ=E[∑tAπ(st,at) ∇θlog⁡πθ(at∣st)]\nabla_\theta J = \mathbb{E}\left[\sum_t A^\pi(s_t,a_t) \,\nabla_\theta\log\pi_\theta(a_t\mid s_t)\right]

7. Generalized Advantage Estimation(广义优势估计)

GAE 的目标:构造一个既低方差又低偏差的优势估计 A^t\hat{A}_t。

优势函数

Aπ(st,at)=Qπ(st,at)−Vπ(st).A^\pi(s_t,a_t) = Q^\pi(s_t,a_t) - V^\pi(s_t).

回报定义

Qπ(st,at)=E[Gt].Q^\pi(s_t,a_t) = \mathbb{E}[G_t].

TD 残差(1-step advantage)

δt=rt+γV(st+1)−V(st).\delta_t = r_t + \gamma V(s_{t+1}) - V(s_t).

  • 方差小(只看 1 个 step)

  • 偏差大(只用 1-step TD)

更一般的 k-step advantage:

At(k)=∑l=0k−1γlrt+l+γkV(st+k)−V(st).A^{(k)}_t = \sum_{l=0}^{k-1} \gamma^l r_{t+l} + \gamma^k V(s_{t+k}) - V(s_t).

特殊情况:

  • k=1k=1:TD(0)
  • k=∞k=\infty:使用完整回报 GtG_t,方差最大

GAE 的核心思想: 将不同 k-step 混合。GAE 使用一个系数 λ∈[0,1]\lambda\in[0,1],将不同 k-step 的优势按几何权重混合:

A^tGAE(γ,λ)=(1−λ)∑k=1∞λk−1At(k).\hat{A}^{\mathrm{GAE}(\gamma,\lambda)}_t = (1-\lambda)\sum_{k=1}^\infty \lambda^{k-1} A^{(k)}_t.

这是 GAE 的定义,但形式不够适合计算。

8. 将 k-step 展开 → 得到“TD 残差累加”形式(关键步骤)

我们先把几个小的 k 看一眼,观察规律:

  • 1-step (k=1):

At(1)=rt+γV(st+1)−V(st)=δt.A_t^{(1)} = r_t + \gamma V(s_{t+1}) - V(s_t) = \delta_t.

  • 2-step (k=2):

At(2)=rt+γrt+1+γ2V(st+2)−V(st)=rt+γV(st+1)−V(st)⏟δt+γ(rt+1+γV(st+2)−V(st+1))⏟δt+1=δt+γδt+1.\begin{aligned} A_t^{(2)} &= r_t + \gamma r_{t+1} + \gamma^2 V(s_{t+2}) - V(s_t) \\ &= \underbrace{r_t + \gamma V(s_{t+1}) - V(s_t)}_{\delta_t} + \gamma \underbrace{\big(r_{t+1} + \gamma V(s_{t+2}) - V(s_{t+1})\big)}_{\delta_{t+1}} \\ &= \delta_t + \gamma \delta_{t+1}. \end{aligned}

  • 3-step (k=3):

At(3)=rt+γrt+1+γ2rt+2+γ3V(st+3)−V(st)=δt+γδt+1+γ2δt+2.\begin{aligned} A_t^{(3)} &= r_t + \gamma r_{t+1} + \gamma^2 r_{t+2} + \gamma^3 V(s_{t+3}) - V(s_t) \\ &= \delta_t + \gamma \delta_{t+1} + \gamma^2 \delta_{t+2}. \end{aligned}

可以猜到一般形式:

At(k)=∑l=0k−1γlδt+l.\boxed{ A_t^{(k)} = \sum_{l=0}^{k-1} \gamma^l \delta_{t+l}. }

GAE 的定义(λ-return 形式)是

A^tGAE(γ,λ)=(1−λ)∑k=1∞λk−1At(k).\hat{A}_t^{\mathrm{GAE}(\gamma,\lambda)} = (1-\lambda)\sum_{k=1}^{\infty} \lambda^{k-1} A_t^{(k)}.

现在代入得到:

A^t=(1−λ)∑k=1∞λk−1(∑l=0k−1γlδt+l)=(1−λ)∑k=1∞∑l=0k−1λk−1γlδt+l.\begin{aligned} \hat{A}_t &= (1-\lambda)\sum_{k=1}^{\infty} \lambda^{k-1} \left( \sum_{l=0}^{k-1} \gamma^l \delta_{t+l} \right) \\ &= (1-\lambda)\sum_{k=1}^{\infty} \sum_{l=0}^{k-1} \lambda^{k-1}\gamma^l \delta_{t+l}. \end{aligned}

交换求和顺序,把“按 k 累加”变成“按 l 累加”,注意对每个固定的 ll,它出现于所有 k≥l+1k \ge l+1的项中。于是:

A^t=(1−λ)∑l=0∞(γlδt+l∑k=l+1∞λk−1).\hat{A}_t = (1-\lambda)\sum_{l=0}^{\infty} \left( \gamma^l \delta_{t+l} \sum_{k=l+1}^{\infty} \lambda^{k-1} \right).

我们只需计算几何级数:

∑k=l+1∞λk−1=λl∑j=0∞λj=λl⋅11−λ.\sum_{k=l+1}^{\infty} \lambda^{k-1} = \lambda^l \sum_{j=0}^{\infty} \lambda^j = \lambda^l \cdot \frac{1}{1-\lambda}.

代回:

A^t=(1−λ)∑l=0∞γlδt+l(λl⋅11−λ)=∑l=0∞(γlλl)δt+l=∑l=0∞(γλ)lδt+l.\begin{aligned} \hat{A}_t &= (1-\lambda)\sum_{l=0}^{\infty} \gamma^l \delta_{t+l} \left( \lambda^l \cdot \frac{1}{1-\lambda} \right) \\ &= \sum_{l=0}^{\infty} (\gamma^l \lambda^l) \delta_{t+l} = \sum_{l=0}^{\infty} (\gamma\lambda)^l \delta_{t+l}. \end{aligned}

于是得到 GAE 最常用的形式:

A^t=∑l=0∞(γλ)lδt+l\boxed{ \hat{A}_t = \sum_{l=0}^{\infty} (\gamma\lambda)^l \delta_{t+l} }

其中

δt=rt+γV(st+1)−V(st).\delta_t = r_t + \gamma V(s_{t+1}) - V(s_t).

9. GAE 的递推形式(计算最方便)

对有限 horizon TT,从后往前递推:

A^t=δt+γλA^t+1.\hat{A}_t = \delta_t + \gamma\lambda \hat{A}_{t+1}.

这是所有 PPO 实现使用的形式。

为什么 GAE 好?

  • λ=0\lambda = 0:纯 TD → 最小方差 / 最大偏差
  • λ=1\lambda = 1:Monte-Carlo → 无偏 / 最大方差

GAE 用 λ\lambda平衡二者:

λ\lambda越大 → 更像 MC,偏差小、方差大

λ\lambda越小 → 更像 TD,偏差大、方差小

通常 λ=0.95\lambda = 0.95是最佳经验值。

10. 新旧策略与重要性采样比率

在实际算法中,数据通常是用“旧策略” πθold\pi_{\theta_{\text{old}}}采样得到的,
但我们要优化的是“新策略” πθ\pi_\theta。

利用重要性采样:

Ea∼πθ(⋅∣s)[f(s,a)]=Ea∼πθold(⋅∣s)[πθ(a∣s)πθold(a∣s)f(s,a)].\mathbb{E}_{a\sim\pi_\theta(\cdot\mid s)}[f(s,a)] = \mathbb{E}_{a\sim\pi_{\theta_{\text{old}}}(\cdot\mid s)}\left[ \frac{\pi_\theta(a\mid s)}{\pi_{\theta_{\text{old}}}(a\mid s)} f(s,a) \right].

定义比率:

rt(θ)=πθ(at∣st)πθold(at∣st).r_t(\theta) = \frac{\pi_\theta(a_t\mid s_t)}{\pi_{\theta_{\text{old}}}(a_t\mid s_t)}.

于是可以写出一个“替代目标”(surrogate objective):

LPG(θ)=Et∼πθold[rt(θ) A^t].L^{\mathrm{PG}}(\theta) = \mathbb{E}_{t\sim\pi_{\theta_{\text{old}}}}\big[ r_t(\theta)\,\hat{A}_t \big].

其梯度就是策略梯度的近似:

∇θLPG(θ)≈∇θJ(θ).\nabla_\theta L^{\mathrm{PG}}(\theta) \approx \nabla_\theta J(\theta).

11. TRPO:加 KL 约束的优化

TRPO 的思想:

最优化 LPG(θ)L^{\mathrm{PG}}(\theta),但限制新旧策略的 KL 距离不要太大。

形式为:

max⁡θ Et[rt(θ) A^t]\max_\theta\ \mathbb{E}_t\big[ r_t(\theta)\,\hat{A}_t \big]

s.t.Et[KL(πθold(⋅∣st) ∥ πθ(⋅∣st))]≤δ.\text{s.t.}\quad \mathbb{E}_t\big[ \mathrm{KL}\big(\pi_{\theta_{\text{old}}}(\cdot\mid s_t)\,\|\,\pi_\theta(\cdot\mid s_t)\big) \big] \le \delta.

这在实现上需要二阶信息(Fisher 信息矩阵),比较复杂。


12. Proximal Policy Optimization,PPO 用剪切(clip)近似 TRPO

PPO 的想法:

不显式做 KL 约束,而是 直接在比率 rt(θ)r_t(\theta)上做剪切,
让每次更新“不要离旧策略太远”。

PPO 定义“剪切替代目标”(clipped surrogate objective):

LCLIP(θ)=Et[min⁡(rt(θ) A^t, clip(rt(θ),1−ϵ,1+ϵ) A^t)].L^{\mathrm{CLIP}}(\theta) = \mathbb{E}_t\Big[ \min\big( r_t(\theta)\,\hat{A}_t,\ \mathrm{clip}(r_t(\theta), 1-\epsilon, 1+\epsilon)\,\hat{A}_t \big) \Big].

解释:

  • 当 rt(θ)r_t(\theta)在 [1−ϵ,1+ϵ][1-\epsilon, 1+\epsilon]里面时,
    用原始项 rt(θ)A^tr_t(\theta)\hat{A}_t。
  • 当 rt(θ)r_t(\theta)偏离 1 太多时,用截断后的
    clip(rt(θ),1−ϵ,1+ϵ)A^t\mathrm{clip}(r_t(\theta), 1-\epsilon, 1+\epsilon)\hat{A}_t,
    防止策略变化过大。

这相当于把 TRPO 的 KL 约束替换为一个更简单的“局部更新限制”。

13. PPO 的完整损失(加入 Value Clipping 与熵正则)

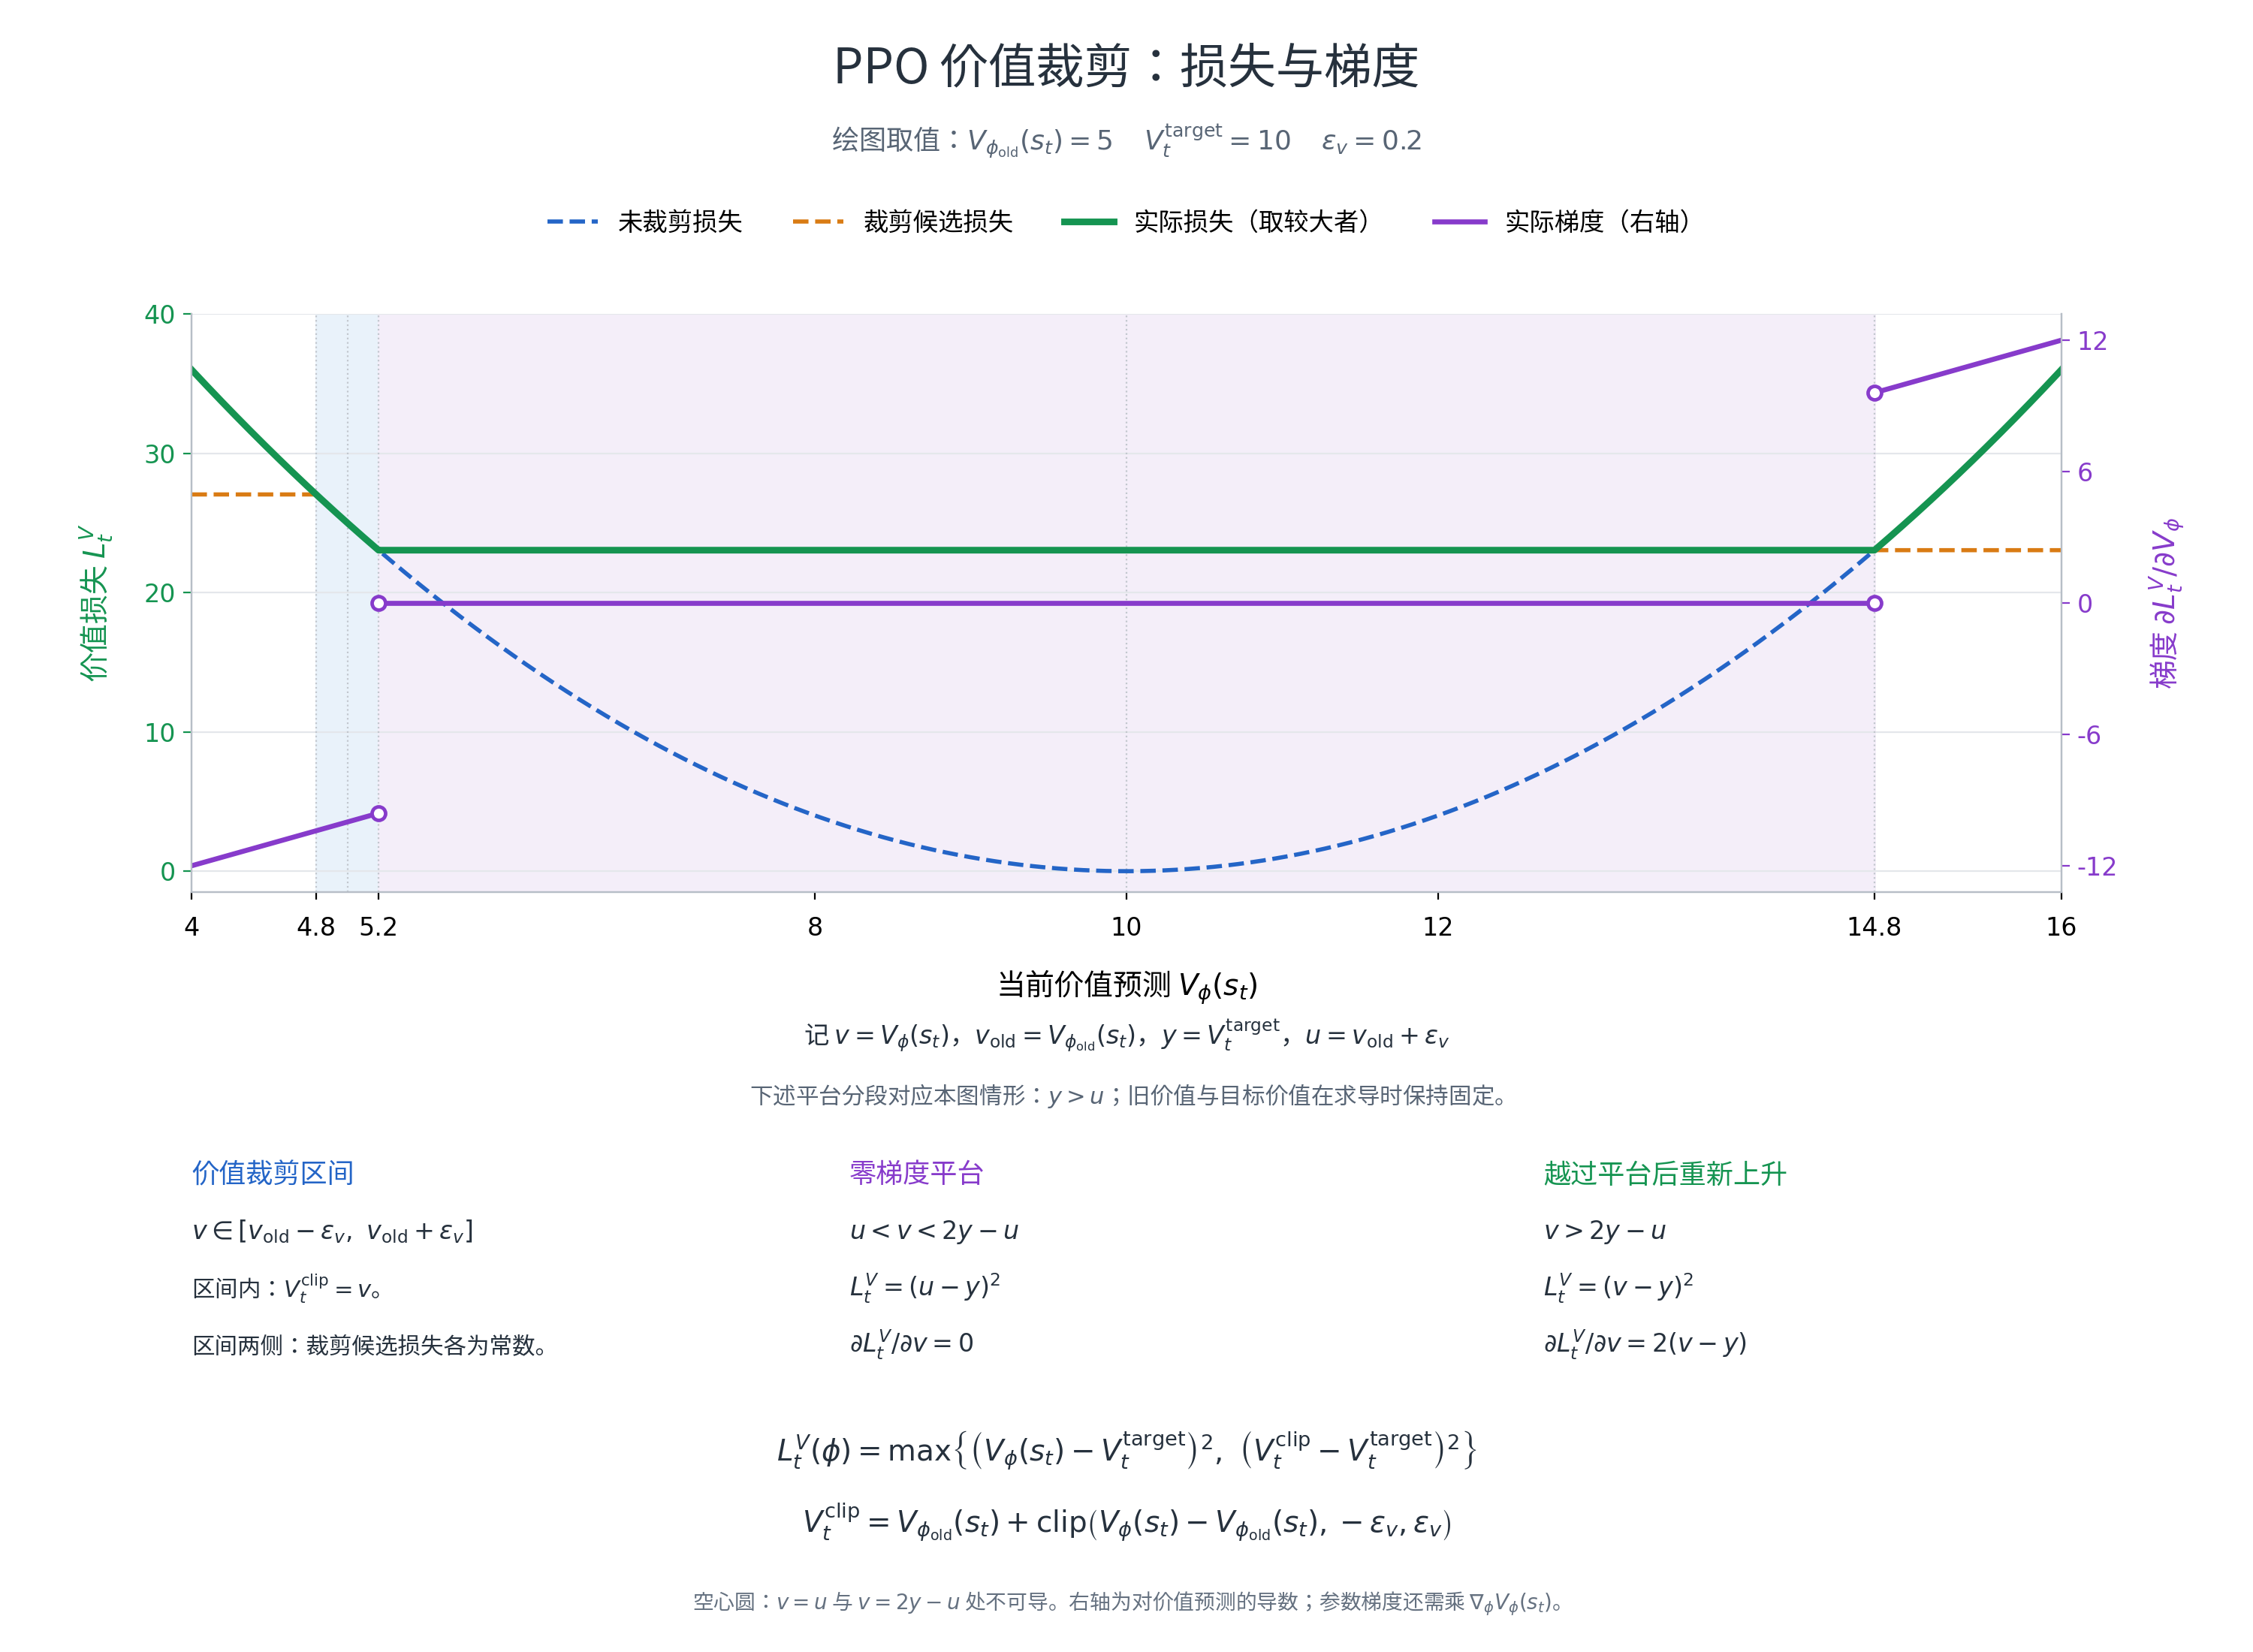
实际训练时,PPO 通常同时学习价值函数 VϕV_\phi,并加入 value clipping 与熵正则:

LPPO(θ,ϕ)=Et[LCLIP(θ)−c1LtV(ϕ)+c2H(πθ(⋅∣st))],L^{\mathrm{PPO}}(\theta,\phi) = \mathbb{E}_t\Big[ L^{\mathrm{CLIP}}(\theta) - c_1 L_t^{V}(\phi) + c_2 \mathcal{H}\big(\pi_\theta(\cdot\mid s_t)\big) \Big],

其中价值函数损失采用 clipped value loss:

LtV(ϕ)=max⁡((Vϕ(st)−Vttarget)2,(Vtclip−Vttarget)2),L_t^{V}(\phi) = \max\Big( (V_\phi(s_t)-V_t^{\mathrm{target}})^2, (V_t^{\mathrm{clip}}-V_t^{\mathrm{target}})^2 \Big),

这里

Vtclip=Vϕold(st)+clip(Vϕ(st)−Vϕold(st),−ϵv,ϵv).V_t^{\mathrm{clip}} = V_{\phi_{\mathrm{old}}}(s_t) + \mathrm{clip}\Big( V_\phi(s_t)-V_{\phi_{\mathrm{old}}}(s_t), -\epsilon_v,\epsilon_v \Big).

  • VttargetV_t^{\mathrm{target}}:回报、TD target 或 GAE 对应的 value target;
  • H\mathcal{H}:策略熵,鼓励探索;
  • c1,c2c_1,c_2:损失权重超参数;
  • ϵv\epsilon_v:value clipping 范围,通常与 policy clip 的 ϵ\epsilon 相同或接近。

value clipping 的作用是限制:

Vϕ(st)−Vϕold(st)V_\phi(s_t)-V_{\phi_{\mathrm{old}}}(s_t)

的变化幅度,避免价值函数更新过快,从而提升训练稳定性。

这个value clipping 可没有想象的简单

policy的clip用的是ratio,而在value中用的是直接对value绝对值裁切,也就意味着我们是对value的范围是有要求的,如果value尺度过大可能会产生问题!

OpenAI Baselines 引入基于折扣累计奖励的归一化,为减轻奖励尺度对 critic 训练的影响,可以维护过去奖励的折扣累计量:

zt=γzt−1+rtz_t=\gamma z_{t-1}+r_t

统计历史所有 (z_t) 的运行方差,然后缩放当前奖励:

r~t=clip⁡(rtVar⁡(z)+ε,−10,10)\tilde r_t= \operatorname{clip}\left( \frac{r_t}{\sqrt{\operatorname{Var}(z)+\varepsilon}}, -10,10 \right)

这里:

  • $ z_t $ 是估计尺度的辅助统计量,不是未来回报,也不是 GAE target。
  • 只除以标准差,不减去奖励均值。
  • 外层裁剪限制统计不稳定或异常奖励造成的极端值。
  • 归一化奖励用于训练,原始奖励仍用于记录 episode return。

14. GRPO:Group Relative Policy Optimization

对每个输入 xx,采样 KK条序列:

y1,…,yK∼πθold(⋅∣x)y_1,\dots,y_K\sim\pi_{\theta_{\text{old}}}(\cdot\mid x)

奖励:

ri=r(x,yi)r_i=r(x,y_i)

组内基线(核心)

rˉ(x)=1K∑i=1Kri\bar{r}(x)=\frac{1}{K}\sum_{i=1}^K r_i

定义组相对优势:

Ai=ri−rˉ(x)A_i = r_i - \bar{r}(x)

比率(整条序列级别)

ratioi(θ)=πθ(yi∣x)πθold(yi∣x)ratio_i(\theta) = \frac{\pi_\theta(y_i\mid x)}{\pi_{\theta_{\text{old}}}(y_i\mid x)}

GRPO 目标(PPO + 组优势)

Liclip(θ)=min⁡ ⁣(ratioi(θ)Ai,  clip(ratioi(θ),1−ϵ,1+ϵ)Ai)L_i^{\mathrm{clip}}(\theta)= \min\!\left( ratio_i(\theta)A_i,\; \mathrm{clip}(ratio_i(\theta),1-\epsilon,1+\epsilon)A_i \right)

组平均:

LGRPO(θ)=Ex[1K∑i=1KLiclip(θ)]L^{\mathrm{GRPO}}(\theta) = \mathbb{E}_{x}\left[ \frac{1}{K}\sum_{i=1}^K L_i^{\mathrm{clip}}(\theta) \right]

加 KL-正则(常用于 LLM)

LfullGRPO(θ)=Ex[1K∑i=1KLiclip(θ)−β KL(πθ(⋅∣x) ∥ πref(⋅∣x))]L^{\mathrm{GRPO}}_{\mathrm{full}}(\theta) = \mathbb{E}_{x}\left[ \frac{1}{K}\sum_{i=1}^K L_i^{\mathrm{clip}}(\theta) -\beta\,\mathrm{KL}\big(\pi_\theta(\cdot\mid x)\,\|\,\pi_{\mathrm{ref}}(\cdot\mid x)\big) \right]